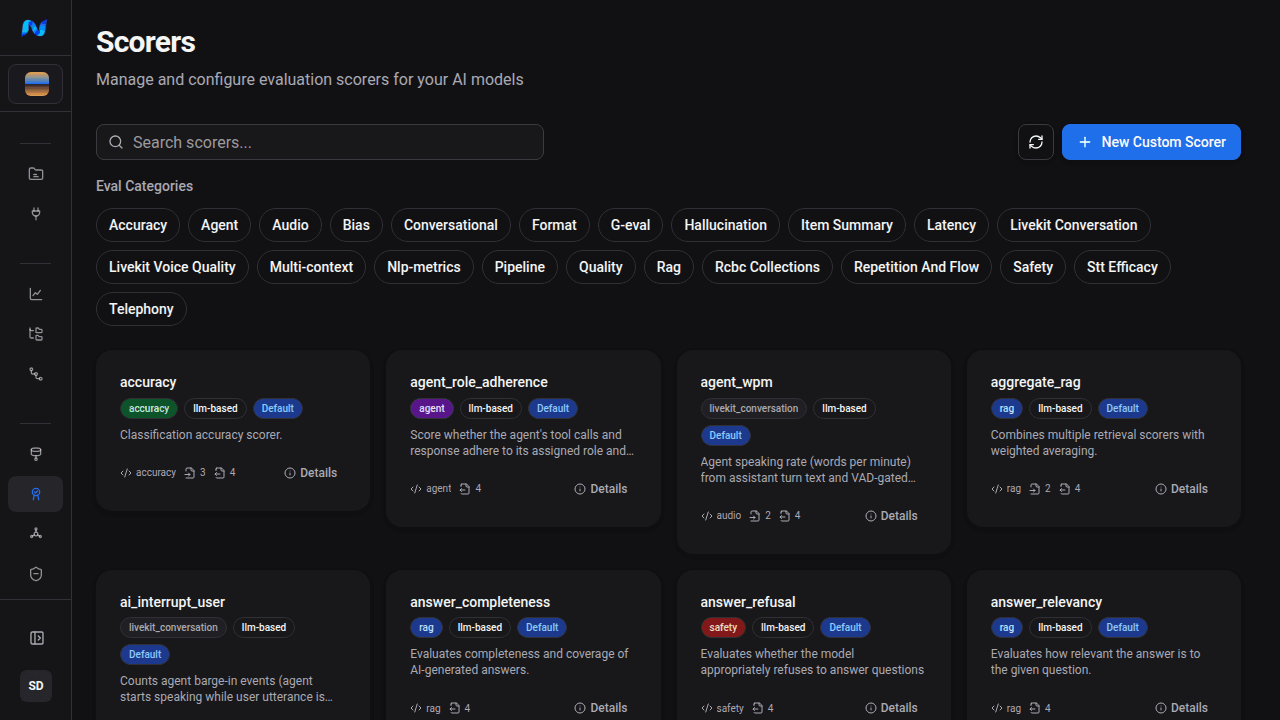
112 Scorer, 15 Kategorien
Wählen Sie kompatible Prüfungen für Halluzination, RAG-Qualität, Antwortkorrektheit, Tool-Nutzung, Kohärenz und Sicherheit. Die Bibliothek umfasst 82 Premium- und 30 kostenlose Scorer.
Evaluierung
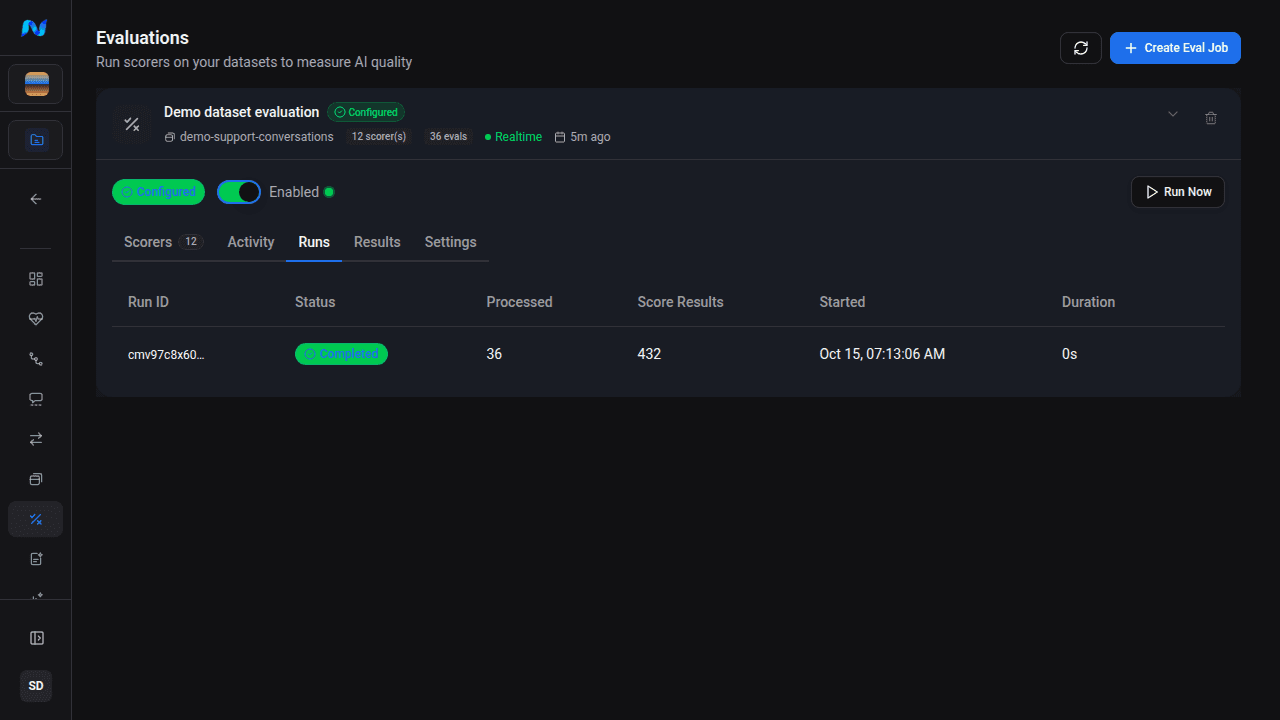
NovaEval wendet ausgewählte kompatible Scorer auf konfigurierte Dataset-Elemente an. Die Bibliothek umfasst 112 veröffentlichte Scorer in 15 Kategorien, darunter 76 modellgestützte sowie 36 spezialisierte Sprach- und Audio-Scorer, ergänzt um benutzerdefinierte Scorer auf Grundlage von Bewertungsrastern.
112
veröffentlichte Scorer
15
Scorer-Kategorien
36
spezialisierte Sprach-Scorer
01 - Funktionen
Wählen Sie kompatible Prüfungen für Halluzination, RAG-Qualität, Antwortkorrektheit, Tool-Nutzung, Kohärenz und Sicherheit. Die Bibliothek umfasst 82 Premium- und 30 kostenlose Scorer.
36 Sprach-Scorer messen unter anderem Aussprachefehler, Audioabbrüche, Wortfehlerrate, Gesprächsanteil, Unterbrechungen, Stille und die vollständige Latenz der STT-, LLM- und TTS-Pipeline.
Wählen Sie Anbieter und Modell für kompatible LLM-gestützte Scorer. Die Ergebnisse können eine Begründung enthalten, damit Teams nachvollziehen können, wie eine Bewertung zustande kam.
Verwandeln Sie Produktanforderungen in anweisungsbasierte Scorer mit Vorlagenvariablen wie input_text, output_text, expected_output, retrieved_context und tool_calls. Die separate Scorer-Empfehlungsfunktion kann anhand von Stichprobendaten kompatible veröffentlichte Scorer vorschlagen.
Ein geprüfter, getesteter und gespeicherter ETL-Mapper wandelt geeignete Traces in versionierte Dataset-Elemente um. Aktivieren Sie den Job erst, wenn die zugeordneten Felder der beabsichtigten Evaluierung entsprechen.
Lassen Sie Scorer, Anbieter, Modell, Prompt und Schwellenwert beim Vergleich von Agentenversionen unverändert, damit die Ergebnisse direkt vergleichbar bleiben.
02 - Die Bibliothek
NovaEval bewahrt die native Ausgabe jedes Scorers: numerische Werte, boolesche Werte oder Labels, ergänzt um eine Begründung, sofern der Scorer sie bereitstellt.
03 - Technische Details
112 veröffentlichte Scorer, darunter 76 modellgestützte und 36 Sprach- und Audioprüfungen, ergänzt um vorlagengesteuerte benutzerdefinierte Kriterien und ETL-erzeugte Datasets. Modellgestützte Ergebnisse können die Begründung des Bewerters enthalten.
Scorer-Bibliothek
112 veröffentlichte Scorer in 15 Kategorien: Halluzination, RAG-Qualität, Antwortkorrektheit, Tool-Nutzung, Kohärenz, Sicherheit, Bias, Formatvalidierung und mehr.
Sprach- und Audio-Suite
36 spezialisierte Sprach-Scorer erkennen Aussprachefehler, Audioabbrüche, Wortfehlerrate (WER), Gesprächsanteil, Unterbrechungen, Stille und die Latenz der STT-, LLM- und TTS-Pipeline. Diese Signale sind in einem Transkript nicht sichtbar.
Anbieter- und Modellsteuerung
Bei kompatiblen modellgestützten Scorern können Sie Anbieter und Modell des Bewerters für einen Evaluierungsjob wählen und die Evaluierungskonfiguration damit explizit festlegen.
Individuelle Scorer
Anweisungsbasierte Scorer mit Vorlagenvariablen wie input_text, output_text, expected_output, retrieved_context und tool_calls verwandeln Ihre Produktanforderungen in Evaluierungskriterien.
Scorer-Ausgabe
Scorer bewahren ihre native numerische, boolesche oder labelbasierte Ausgabe sowie den Bestanden-Status und strukturierte Metadaten. Modellgestützte Bewerter können außerdem eine Freitextbegründung zurückgeben.
Datasets aus Datenverkehr
Ein AI Mapper kann vorschlagen, wie ausgewählte Traces zu Dataset-Elementen werden. Prüfen, testen und speichern Sie die Zuordnung, bevor ein aktivierter ETL-Job geeigneten Datenverkehr verarbeitet.
Der Kreislauf
Die Evaluierung liefert Belege für den Rest der Plattform: NovaPilot analysiert konfigurierte Ergebnisse, während NovaGuard separate Ausgaben- und Datenverkehrsrichtlinien speichert, die eine verbundene Laufzeit durchsetzt.
Im Produktivbetrieb bewährt bei Enterprise- und wachstumsstarken Teams